
Lol Audio Unpack:这些年折腾的英雄联盟音频工具
最近给这个工具补好了独立文档,也录了一份操作视频,想着博客里还是应该有一篇文章,把它为什么会出现、这些年又为什么一直改,稍微说清楚。
现在的名字是 Lol Audio Unpack,GitHub 地址还是 lol_extract_voice。早期确实主要提取英雄语音,后来地图、音效、音乐也都加进来了,名字跟着改了,仓库地址就没动。
使用方法已经放在文档里,配了截图,这里就不再从选目录开始讲了。这篇主要回顾我自己怎么折腾到现在。时间隔得太久,有些早期细节只能凭印象说。
录音录烦了
大概 2015 年那会儿,B 站的鬼畜很火,我觉得挺有意思,就跟着教程学了一点。刚开始用的都是教程作者给的素材,学完总想自己做一个。当时也在玩英雄联盟,就想拿某个英雄的台词做鬼畜,或者剪个混剪。
想做视频,先得有素材。最早的方法很直接,进游戏录。
录了一阵就烦了。有些英雄话很多,遇到不同英雄有不同台词,换个皮肤又有一套,对同系列皮肤还可能有特殊互动。为了录一句话,得先把触发条件凑齐,凑齐了也不一定马上说。反正我当时没有耐心把这些都录一遍。
于是开始研究能不能解包。以前虽然没真正做过游戏 MOD,但多少知道一点,声音总归要存在游戏文件里,找出来就不用在游戏里等它开口了。
一个英雄一个英雄地补
-
V1 做的事情,就是拿脚本把已有工具串起来。手工能做的事情,让它替我跑一遍。
-
那时重心还在视频上。先拿到一个英雄的素材,脚本就停在那儿,我去剪视频。剪着剪着发现,只用一个英雄太平了,没什么东西可剪,又回来补其他英雄。
补的时候就发现,有些英雄的路径和前一个不一样,原来的处理方式套不上,又得研究、改脚本。就这么一点点补,慢慢把英雄都加上了。并没有一开始就想好要做一个多完整的工具,纯粹是做视频时缺什么,回来补什么。
-
英雄处理完,发现地图里也有声音。地图比英雄麻烦多了,播报、技能和装备音效、背景音乐,还有一堆零碎声音混在一起。拿到文件以后,找自己需要的东西又成了新的问题。
-
到了 V2,程序已经是按批量处理写的了,从入口就奔着所有英雄一起解包去。想只处理某一个英雄,反而没那么方便。
那时还没有命令行入口,参数都是在主脚本里改。想换一个英雄,就打开脚本,填它的 WAD 路径,再改这次需要处理什么。自己用知道改哪里,别人拿到就不一定了。后来也有人在 Issues 里问怎么用、怎么只处理一部分,那会儿已经过去好多年,程序还带着最早那种自用脚本的习惯。
2019 年我发过一个手工解包的视频,也把处理好的文件分享了出来。资源后来断断续续更新了好几年,直到 2025 年底左右才停下来。这里面还绕过一圈试听网站和网盘,后面再说。
V3 和配置优先级
V3 基本上重写了一遍。V2 的条理不多,能用就行,很多东西放在一起,后来想改就越来越费劲。
这次稍微把模块分清楚了,哪个部分准备数据,哪个部分解包,哪个部分转码,各自该放什么,至少在这个项目里能解释得通。拿去跟成熟项目比肯定还有差距,但自己回来看,总算知道该去哪里改。
命令行也是这一轮慢慢补的。至少不用每次先打开 Python 文件改路径,换个英雄、换个输出目录,传参数就行。可是入口加着加着,又把配置弄复杂了。
最开始想得很全:环境变量、配置文件、命令行都支持。真正开始处理优先级才头疼。用户在命令行写了几个参数,后面又加一个 -c 指定配置文件,环境变量里还留着以前的值,到底该用哪一份?
开发者可以规定谁覆盖谁,可使用者未必按这个规则理解。他可能觉得几种配置是互补的,哪儿缺就从另一份拿;也可能早就忘了环境变量里还放着一个旧目录。最后程序读到了一个值,用户却不知道它从哪儿来的。
现在做了取舍,命令行参数和配置文件分开用,使用 -c 就从配置文件读取动作和参数,不再跟命令行选项混着覆盖。那段三种来源叠在一起的逻辑,处理起来费劲,用起来也没省多少事。
从补全到 Agent
中间停过一段时间。后来有了 AI 辅助,最早用的是 Cursor 那种补全,写个注释,按 Tab 补一段,再自己测试。有时候好用,有时候还得花时间去改,进度也没有一下子快起来。
再后来有了能改文件、跑检查的 Agent,之前积着的东西才推进得快了一些,界面也做出来了。这个界面又刚好接上了很早以前的一个想法:找个英雄,直接试听它的声音。
试听网站和网盘
2020 年疫情那会儿,我想过做一个英雄台词试听网站。脚本已经能解包,声音也有了,找个地方存起来,再做一个网页,按英雄点开听,看起来没有多复杂。
麻烦的是资源放哪儿。
试过把资源放到 GitHub,再借 CDN 或 Cloudflare 之类的服务来访问。测试版也做过,但国内访问不稳定,后来找不到合适的替代办法。现在回头看,这种用法本来也不适合长期依赖。我只是个人开发者,纯爱好,没什么收入,没办法一直花钱养一个音频站。
NOTEWAV 的体积
那时候分享的是 WAV,没有再做有损压缩。我自己听过压缩后的效果,觉得有些声音不太对,就想保留好一点的素材。结果光英雄和地图里的台词,印象中就有三十多 GB。
单条音频看起来没多大,试听时却是一条接一条地点。更别说有人需要全部下载,写个爬虫跑一遍就是整份资源的流量。对使用者来说只是下载,对我来说 CDN 的账单还得照付。真放到付费 CDN 上试过一段时间,后来还是放弃了,纯烧钱,还看不到什么成果。
网盘也折腾得不轻。文件解包、分类、压缩、上传,好不容易分享出来,链接过一阵又失效。我不知道它具体在检测什么,只能按自己碰到的情况试。压缩包加密以后有时能多撑一阵,但也没有彻底解决。
后来改成分享原始 WEM,体积小了很多,上传和下载都轻松一些。WEM 是游戏里用的音频文件,常用的剪辑软件不能像 WAV 一样直接拿来用,还得转码。
我找到了 vgmstream,又改了一下它的控制台程序,让它能扫描目录、按规则批量输出。文件太多,靠命令行一个个填进去肯定不现实。这部分后来也单独留成了一个项目。
文件还是继续更新着,但有时候已经只是习惯性更新了。网盘总出问题,我也看不清到底有多少人下载、还有多少人在用。
本地明明就有游戏文件
中间我还想过把程序改成 Node.js,做成网页:选择本地游戏目录,解包完直接在网页里试听。当时没有把这个想法做完,但这个方向后来一直记着。
到准备做 GUI 的时候,再回头看分享资源这件事,就觉得绕了很大一圈。
很多来找音频的人本身就在玩英雄联盟,电脑里已经有游戏客户端。我从自己的客户端解包,转成 WAV,压缩、上传,再让别人下载、解压。他本地已经有这些声音了,我还让他下一遍,折腾什么呢。
当然,也有人没有安装游戏,或者专门想找重做前的旧语音,那是另外一种情况。程序本身需要本地资源,准备好符合要求的旧版本文件,也可以交给它处理,不会替用户下载客户端。
但对已经有游戏文件的人来说,给他一个界面,选好目录,处理完就能找、能听,需要哪几条再导出,明显方便得多。我也不用再维护一堆网盘链接。
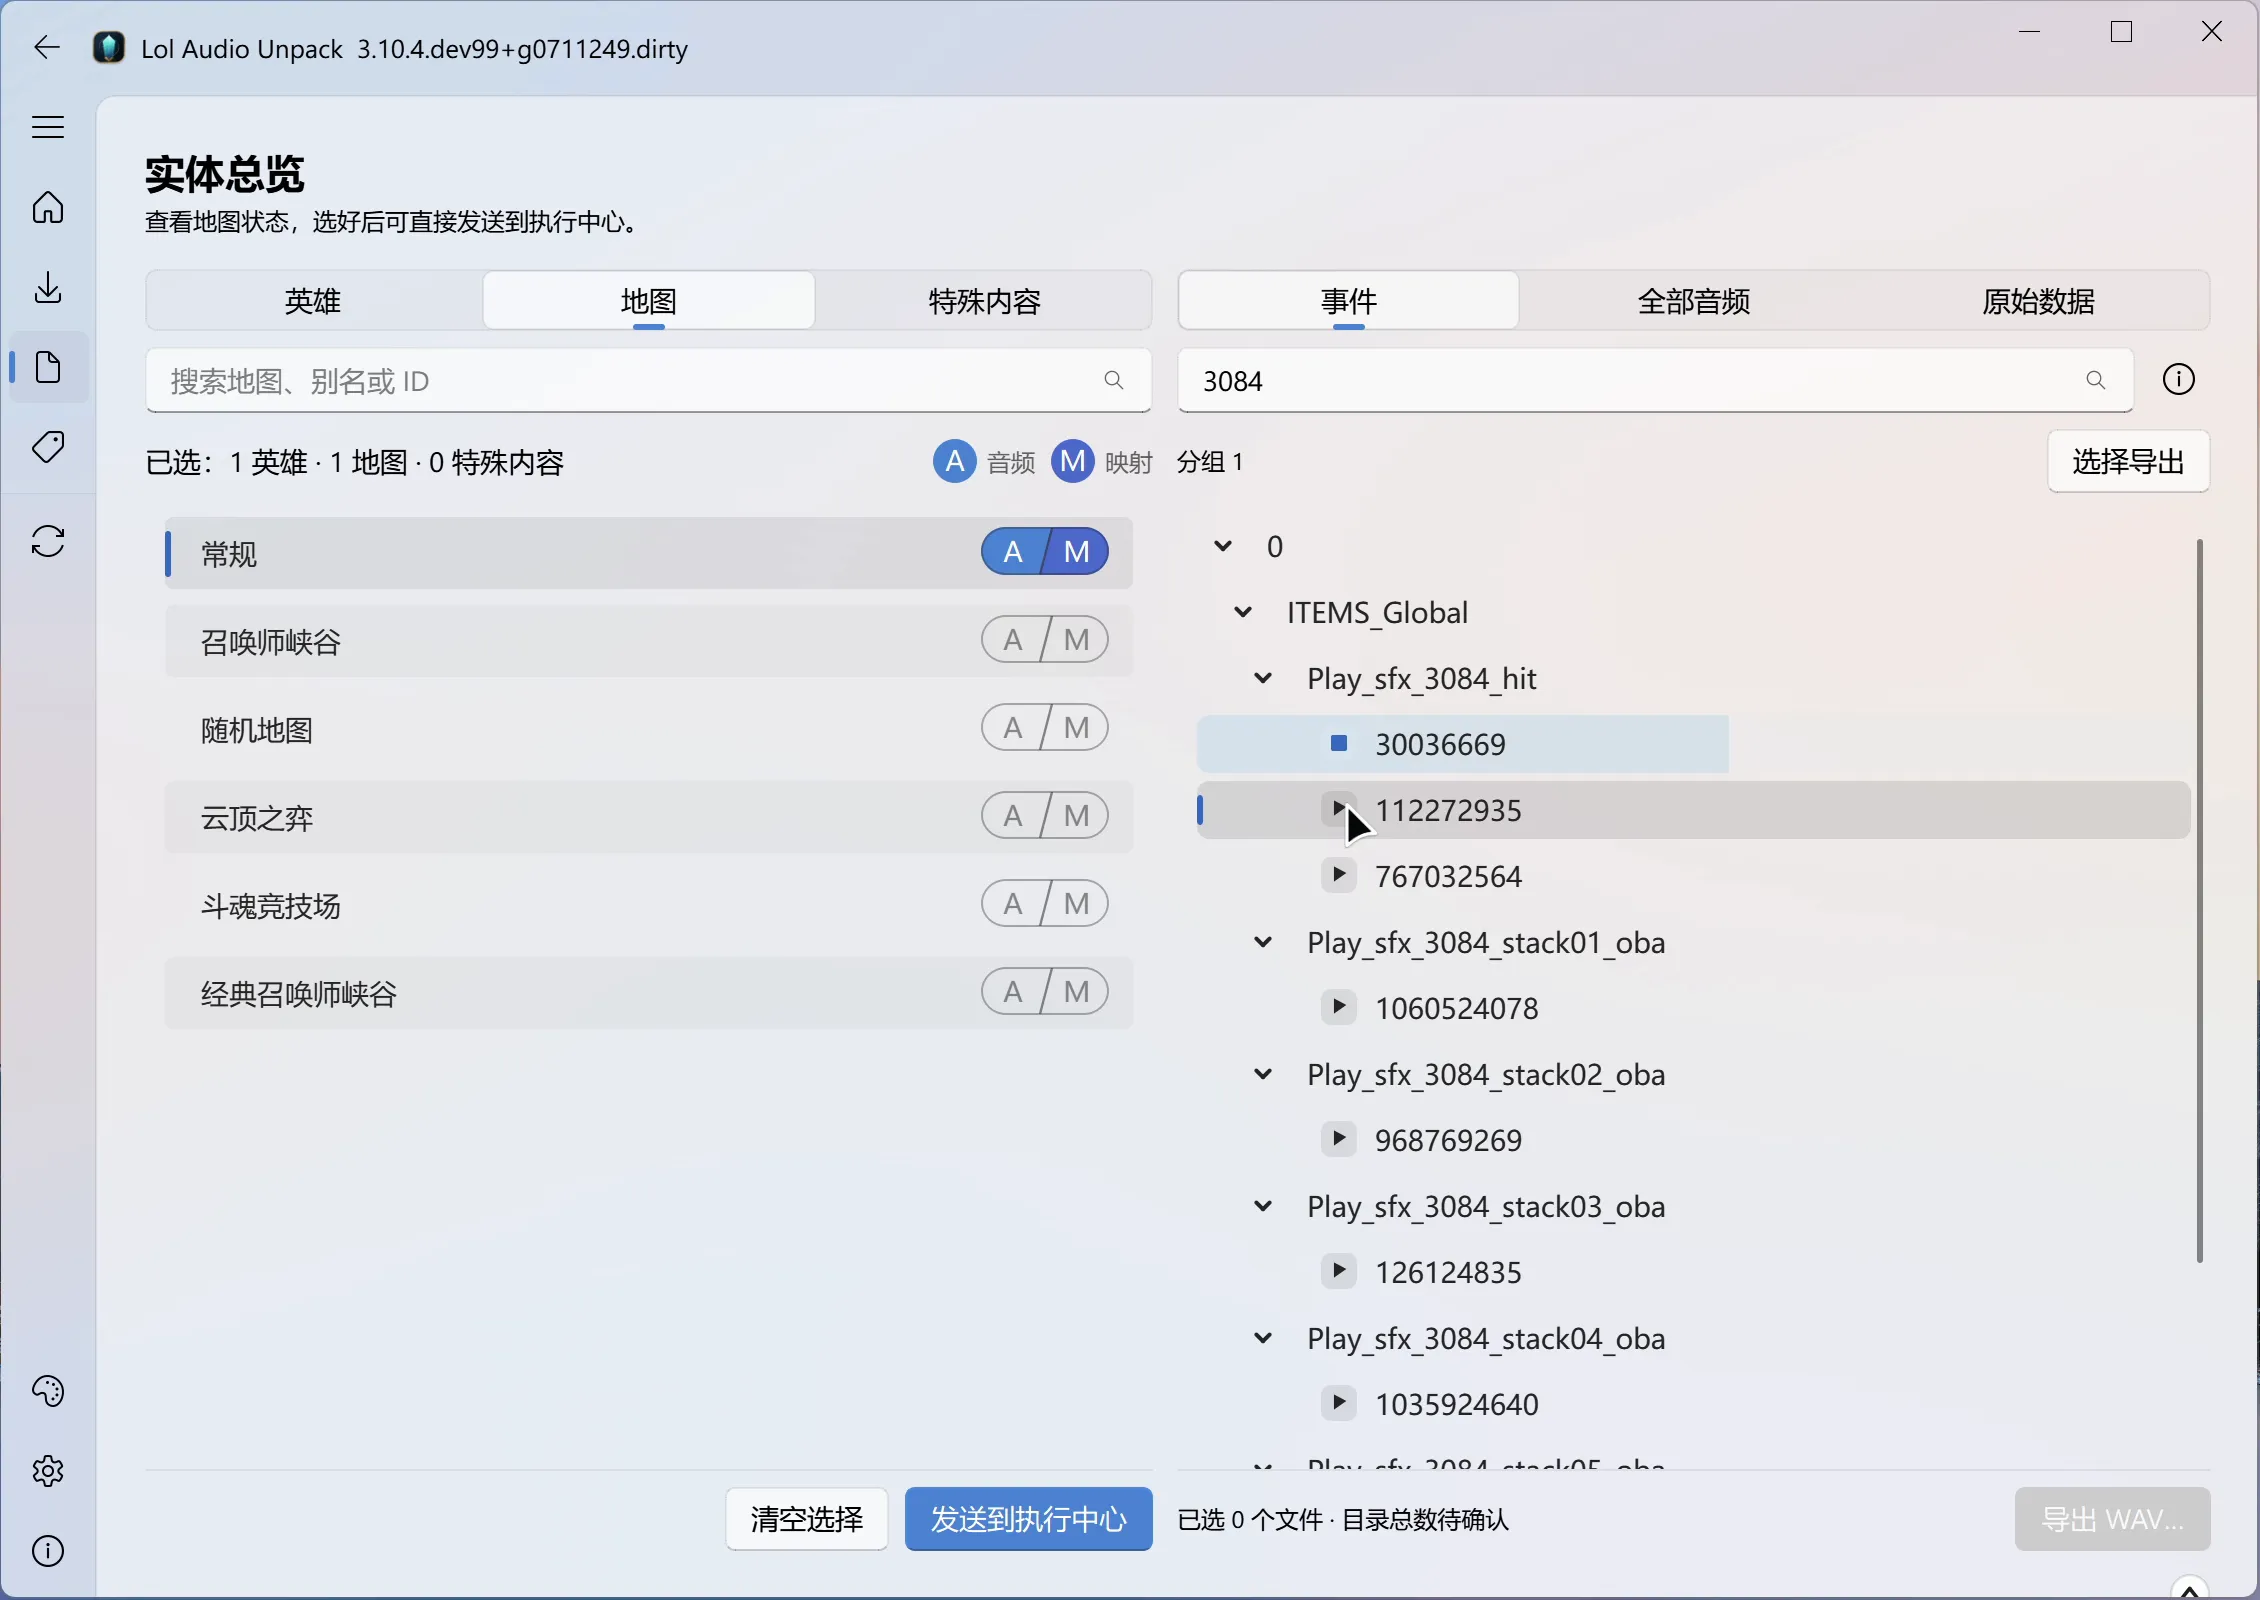
当前界面截图,取自项目文档。图中是在常规地图里查找心之钢音效。
这也比较符合实际需求。很多人只是想找个金身音效、地图标记声,或者某个英雄的几句台词,用不着下载整份英雄或地图音频包。以前分享时总得按英雄、地图这些单位打包,不可能一个音效一个压缩包。现在直接在本地找,选几条导出就行。
虽然还是 Python 写的,但已经优化过几轮,解包速度对我来说够用了。我之前在自己电脑上试过,全部台词语音的解包加转码大概十五分钟,后来又做了一些优化。这个只是那次处理的耗时,不包括把所有音效都转一遍。
全量处理里,转码通常更慢,尤其音效文件又小又多,CPU 和硬盘都可能卡住,换台电脑、换一批资源,耗时也会变。
能只转自己挑出来的几条,省下来的时间比继续死磕全量转码速度还明显。
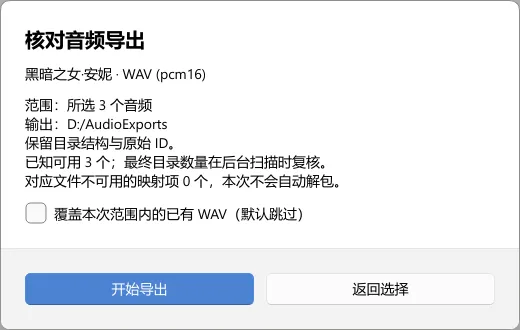
试听后只导出自己需要的声音,不用先把整个资源包转成 WAV。
用 Obsidian 加其他工具手工解包,当然也能拿到这些文件。我写这个程序,一直就是为了省这些重复操作,现在界面把找素材的过程也接上了。
视频没怎么做,工具还在改
写到现在,其实早就偏离最初做鬼畜的目的了。那时遇到一个问题就去改脚本,后来反而花更多时间研究声音怎么整理、程序怎么写,视频没做出多少。
也有我自己的原因。早期看鬼畜,会觉得什么素材都能拿来剪,老素材也能玩出新东西。后来我看的不少视频,更像把最近火的梗揉在一起,做一段时间的汇总。我跟这些热梗的速度没有那么快,有些看了解释,也还是不知道笑点在哪儿。
这只是我自己的理解,倒不是说笑点有多高。做视频总得先知道自己在笑什么,我自己都没弄懂,就更不知道该怎么剪给别人看。慢慢没什么灵感,重心也就移到工具上了。
以前想做的试听网站,最后没有按网站的形式留下来。现在这个本地界面,倒是让我能找个英雄,点开听,挑几条导出去用了。当年的那个需求算是有了一个能用的结果。
事件名和台词,还有两个坑
文件能解出来,能播放,接下来还得知道它是什么。
事件名的翻译
现在可以按事件查找,但事件名是游戏内部用的,有些新英雄命名比较规整,老英雄和旧资源就不一定了。有缩写,有历史命名,也有光看英文猜不出来的东西。词典能翻译单词,未必能告诉我它在这个英雄身上代表什么。
我想做的是把这些事件整理成人能看懂的描述,至少知道大概怎么触发、该往哪里找。以后如果能整理好,也可以再做不同语言的显示。这个方向放在 lol-event-semantics 里,目前还在慢慢研究。
难点是数量太多,还需要理解英雄机制和皮肤的特殊互动。一个个靠人工校对,工作量太大,而且我也不是每个英雄都懂。交给大模型试过一些,效果还没有好到能直接全部用上,逐条核对又要花很多时间和 token,只能慢慢来。
另外一个坑是语音转文本。
2020 年那篇台词整理文章里就试过语音识别,后来也试过腾讯、讯飞这些服务,识别完再人工听、核对。
普通人说话还好,英雄联盟里很大一部分英雄设定上就不是人,说话方式、口音、后期特效都有,光靠自动识别不太放心。人工也不是听一遍就保证正确,还是得反复核验。
后来陆续人工核对过大概一百个英雄,花了不少时间。几个游戏版本过去,再解包一遍,原来的音频 ID 对不上了。
举个例子,同一句话这个版本叫 12345.wem,下个版本可能换成 45678.wem;反过来,同一个 ID 下的文件内容也可能变化。如果把整理好的台词直接挂在 ID 上,后面更新时就容易错位。那会儿还不知道会这样,发现自己处理过的对应关系不能直接继续用,就停下来了。
后来专门做了历史版本的实测,确认这两种情况都存在。现在资源库按原始 WEM 的实际内容做哈希,同样的字节内容可以复用,不同版本的 ID 则分别记录它们指向什么。
当前的做法是,原始 WEM 内容完全一样,就只存一份,通过硬链接让不同目录引用它。文件名换了,内容没变,仍然能找到同一份内容。解包时还得读取实际源文件,不能因为 ID 没变就直接认定声音也没变。
硬链接共享底层文件,所以直接修改一处可能影响其他引用。需要剪辑时先导出独立的 WAV,或者复制到资源库之外。
这只能判断文件字节是否相同,还不能判断两段声音是不是同一句台词。重新编码、重新录制,都可能让哈希变化;配音老师换个语气说同样的话,文本也可以完全没变。语音转文本和跨版本的台词核对,还得继续研究。
至少现在手里有了能确认原始文件内容是否重复的方法,之前的 ID 问题也有了一个处理方向。但它离自动整理好所有台词,还有不少距离。
顺带拆出来的项目
前面这些事折腾久了,相关工具也慢慢拆出来了。最近这些项目的阶段总结里有整体记录,这里只补它们跟音频工具的关系。
| 项目 | 跟这条音频处理流程的关系 |
|---|---|
| league-tools | 把用到的解析、音频解包等能力整理成独立 Python 包,供上层程序使用。 |
| pyvgmstream | 在 Python 里使用 vgmstream 的解码能力,供程序转码和试听。 |
| vgmstream-cli-build | 之前为了批量转码改过的控制台版本,也能独立使用。 |
| RiotManifest、RiotManifestGo | 处理 Riot 清单与资源下载的另一条工具线,分别有 Python 和 Go 版本。 |
清单和下载有它们自己的项目,现在的 Lol Audio Unpack 处理本地准备好的资源,没有把下载器一起塞进来。后续游戏客户端怎么改、资源怎么组织,还要继续看实际文件;既有的旧资源处理也不能因为新客户端出现就直接扔掉,重做前的语音有人需要,文件也还在那里。
文档和视频
现在软件的使用说明放在 lau.oogoo.top,界面操作、控制台参数、目录规则和版本更新都在那边维护。这篇就留着记开发经过,不跟文档一起逐版本改功能列表。
Lol Audio Unpack 源码仓库仓库地址仍为 lol_extract_voice,代码、Issues 和发布记录都在这里。操作视频放在下面,想跟着界面走一遍可以看视频,具体参数和说明还是查文档方便。
也可以直接到 B 站观看。
最早只是想找点素材,后来视频没怎么做,解包工具倒是一直写到了现在。现在能在自己电脑上找到想要的声音,听一下,导出去用,对我来说已经方便不少。剩下事件名和台词这两个坑,慢慢填吧。
Built with Astro & FangYuan (mod by Fuwari)
 提供CDN加速/云存储服务
 辽公网安备21021302000353号